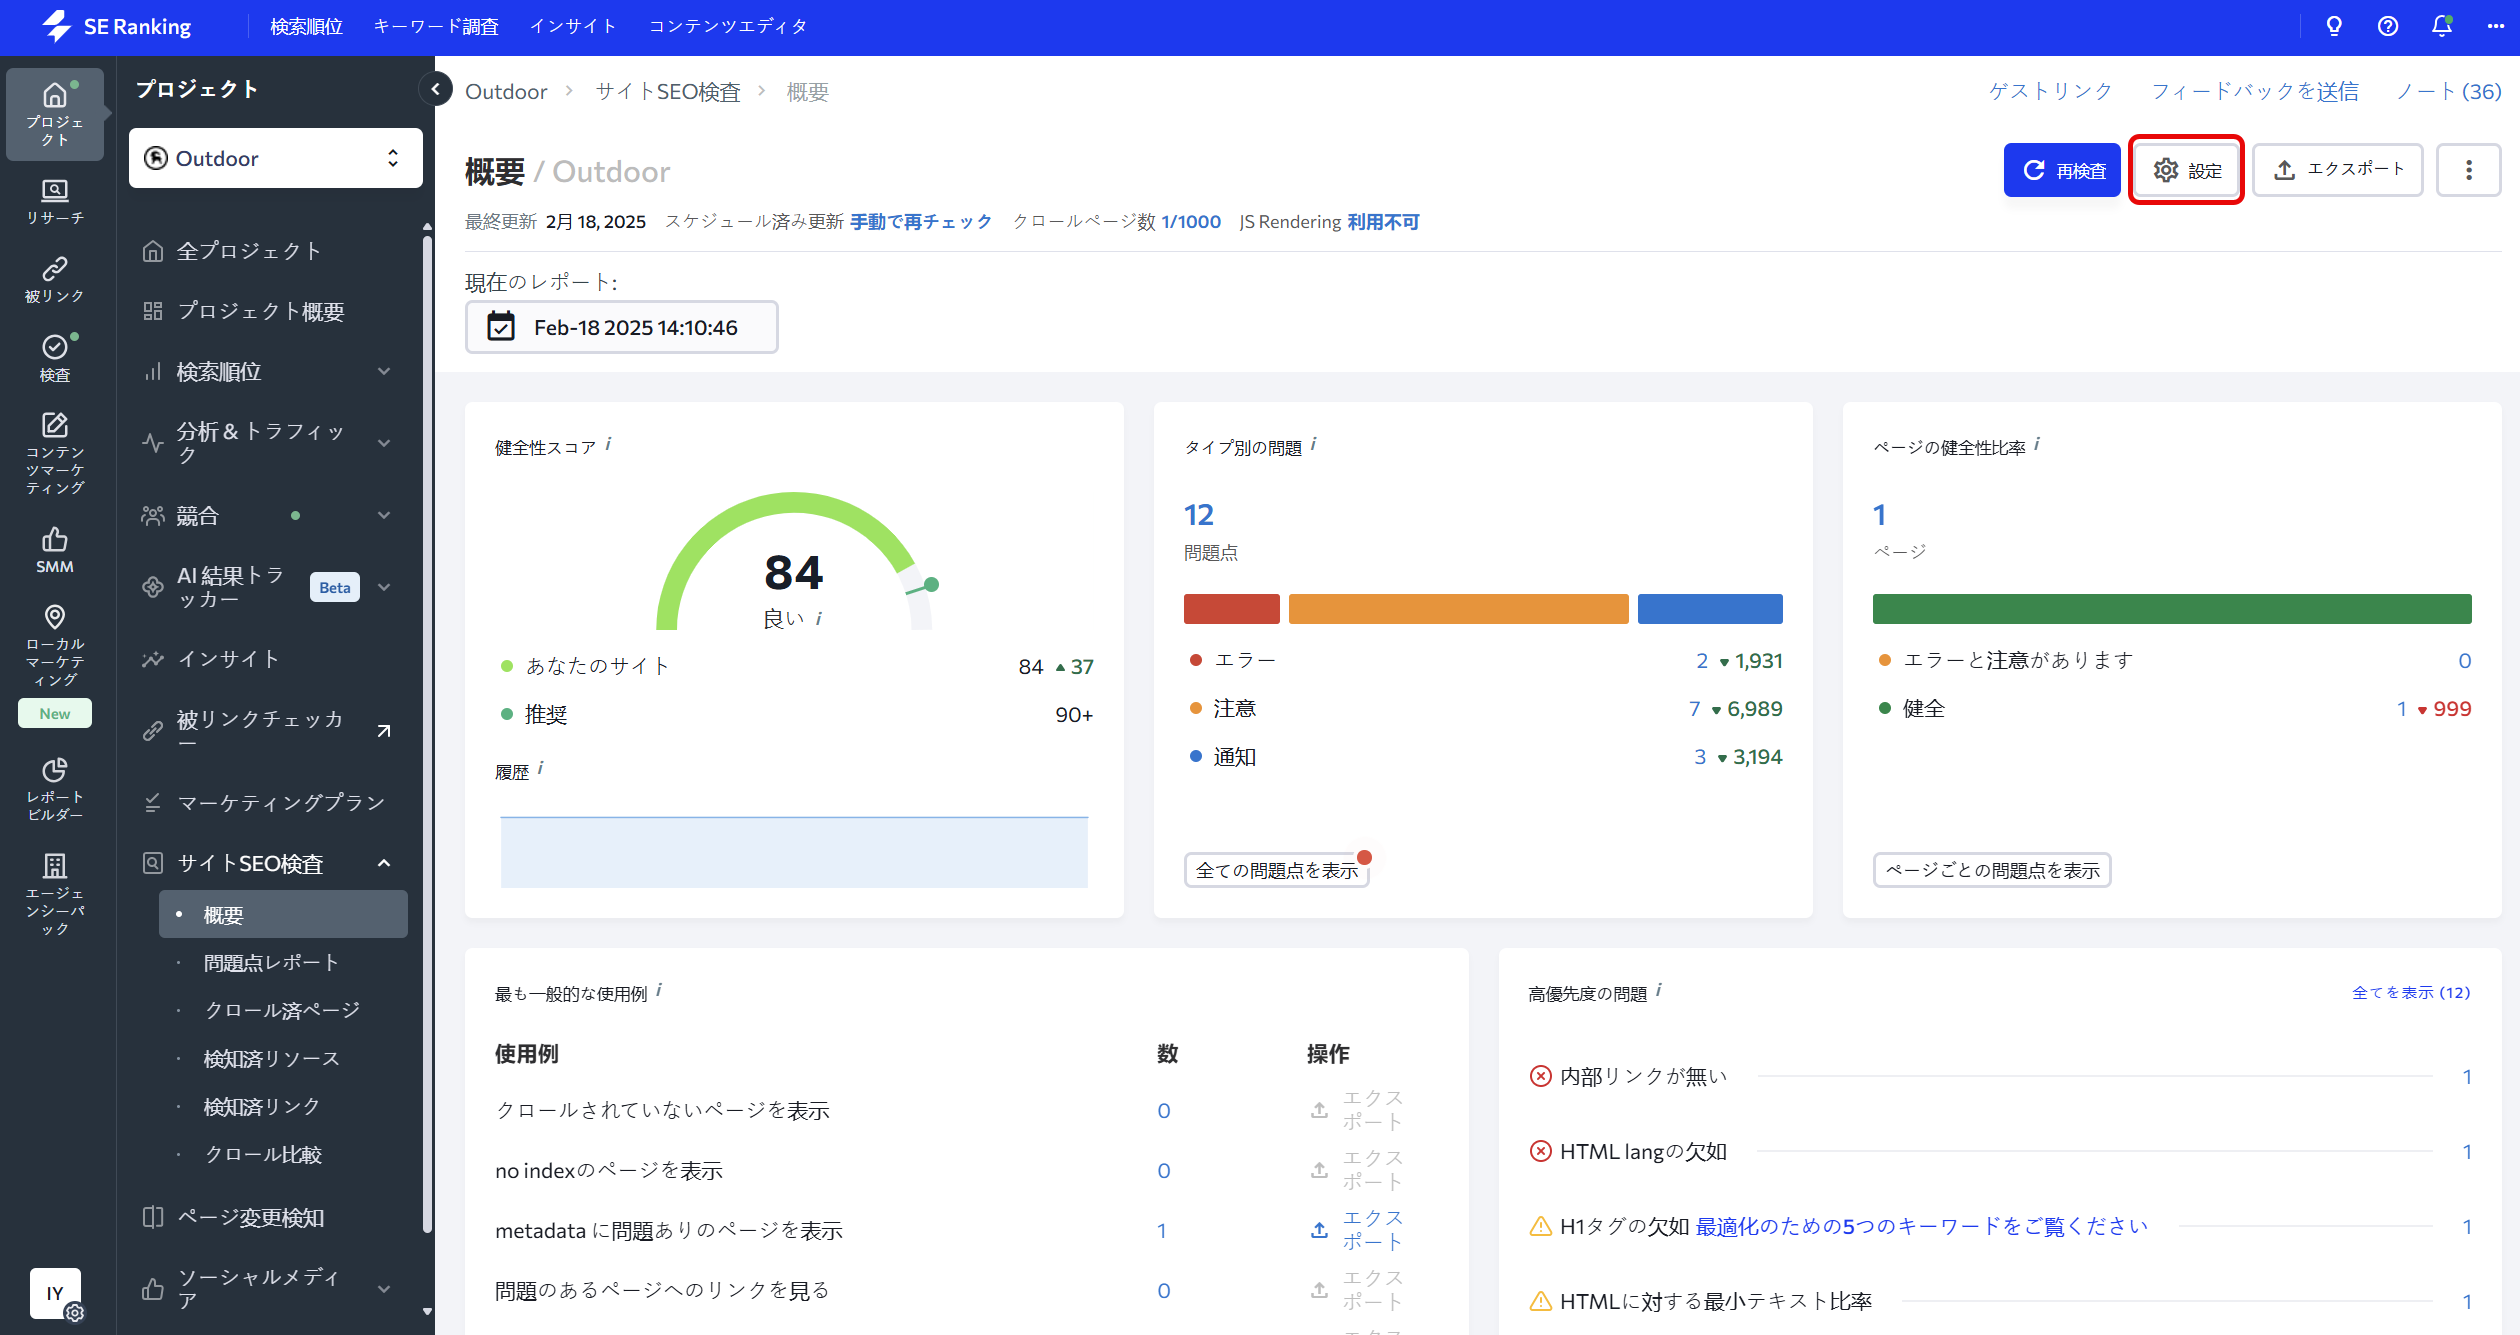
柔軟な設定メニューにより、検査結果同様、全体の処理を完全にコントロールする事ができます。設定はツールのあらゆるセクションからアクセスする事ができます。
スケジュール
この設定ブロックでは、あなたのウェブサイトの検査頻度を指定する事ができます。
以下の方法をご利用頂けます。
1. 手動 - 手動で検査を開始するには、 検査開始 ボタンをクリックしてください。 ツールのあらゆるセクションにこちらのボタンが配置されているので便利です。
2. 週 - お好みの曜日と時間を基準に毎週検査が実施されます。
3. 月 - お好みの週の曜日と時刻を基準に毎月検査が実施されます。
時刻はGMTタイムゾーン のみの指定となります。
自動チェックを設定している場合でも手動による検査はいつでも実施する事ができます。
検査のソース(対象ページ)
設定ブロックでは、検査対象のページを設定する事ができます。
以下のような方法を指定する事ができます。
1. サイトページ - ツールはトップページから開始して、内部リンクを辿ってサブドメインは含まずにサイトの全てのページをクロールします。
2. サブドメイン - ツールはサブドメインも含めてサイトの全てのページをクロールします。
3. XML サイトマップ - ツールはXMLサイトマップに指定されているページを全てクロールします。
最初の検査実施後、ツールは domain.com/sitemap.xml の位置に配置されるXMLサイトマップを自動的に見つけます。 サイトマップ追加 ボタンをクリックして手動でXMLサイトマップ枠にリンクを追加する事ができます。 リンクが追加されたら変更を保存するようにしてください。
4. ページのリスト - 検査対象のウェブページのリストを独自に追加する事ができます。TXT や CSV 形式でファイルをアップロードしてください。 URLは一行ごと入力してください。
サイトSEO検査を開始する前に、スキャンするパスを指定できます。以下のオプションが提 供されます:
- スキャンするディレクトリを1つ以上指定する(パスを許可する)。
- スキャンから除外する(パスを許可しない)ディレクトリを1つ以上指定する。
- レポートに含めないディレクトリを1つ以上指定する。
「noindex」やサイトマップに含まれないページが、それでも監査されるのはなぜですか?
デフォルトのソース「サイトページ」を使用すると、監査はホームページから始まり、すべての内部リンクをたどります。そのため、XMLサイトマップに記載されていないページにも到達することがあります。noindex ディレクティブはインデックス登録を防ぐだけで、クロールを妨げるものではありません。そのため、これらのページも引き続きスキャンされ、問題として検出される場合があります。
特定のページのみを監査するには、「ページのソース」を「XMLサイトマップ」または「ページのリスト」に切り替え、Disallowパスを追加し、「noindexを無視」オプション(下記の「ページ取得ルール」を参照)を無効のままにしてください。これにより、noindexページがスキップされます。
ページ取得ルール
この設定ブロックでは、ウェブページをクロールする際のルールを設定する事ができます。
以下は一つの例です。
1. robots.txtディレクティブを考慮する - このオプションを有効にすると、ツールはrobots.txtファイルの有効な指示リストに沿ってウェブサイトをクロールします。無効にするとツールはrobots.txtの指示を無視します。
2. Noindexを無視 - このオプションが有効の場合は、ツールはNoindexディレクティブ(メタタグやHTTPレスポンスヘッダーの形式)を無視してクロールします。
3. Nofollowを無視 - このオプションを有効化すると、SE RankingボットにNofollowディレクティブ(メタタグやHTTPレスポンスヘッダまたはリンク属性の形式)を無視してページのリンクを辿るよう指示します。
4. allow / disallow URLです。dissalow ディレクティブは allow ディレクティブよりも優先されます。リソースやページについての言及を全く見たくなければ、 非表示に指定してください。
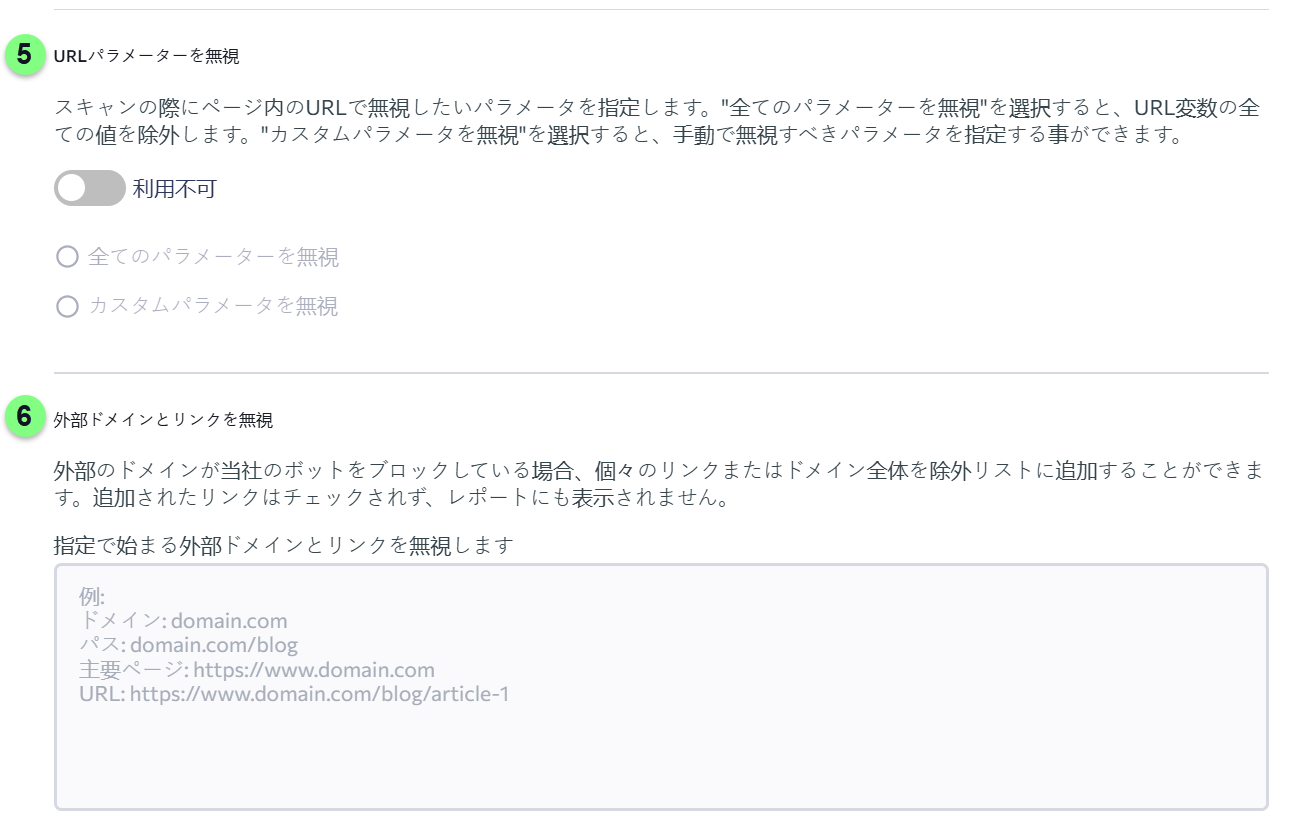
5. URLパラメーターを無視 - ここで検査時のページURLで無視するUTMタグを指定する事ができます。全てのパラメーターを除外する事や、手動で無視するパラーメーターを選択する事ができます。
6. 外部ドメインとリンクを無視。外部のドメインが当社のボットをブロックしている場合、個々のリンクまたはドメイン全体を除外リストに追加することができます。追加されたリンクはチェックされず、レポートにも表示されません。
 解析設定
このツールでは、クロールを行うボットを選択する事ができ、更に検索ロボットのアクセスを閉じているページへのアクセスを提供する事もできます。
1. ユーザーエージェントを選択します
SE Ranking botが標準で選択されています。私達のボットで対象サイトにアクセスできない場合は、リストから別のボットを選択する事ができます。選択するユーザーエージェントの種類に関わらず(仮にGooglebot-Imageを選んだとしても)、サイト上の全てのページがクロールされます。
2. JavaScript レンダリング (クライアントサイドレンダリング)
JavaScriptのクロールは、静的なHTMLのクロールよりもはるかに時間がかかりますが、これは主にJSの処理に時間を必要とするからです。ただし、同時リクエスト数を増やすことで、サイト検査全体のクロール速度を向上させることができます。
3. 制限されたページの権限
公開前のウェブページでもクロールする事ができます。この操作を行うには、該当入力項目にあなたのログイン情報を指定して私達のボットにアクセスを付与します。
上限と制限
このセクションではクロールの上限と制限を設定する事ができます。アカウントのサイトごとに個別に上限や制限を設定する事ができます。
利用可能な設定は以下の通りです。
- スキャンするページの最大数 - あなたの料金プラン範囲内でページ数をお選びください。
- 最大スキャン深度 - クロールする深さ(リンククリック数)を選択します。
- 上限リクエスト数 - サーバーの能力に依存しますが、レポート生成速度を上げる為に、1秒間にサーバーで生じるリクエスト数を増やす事ができます。逆にサーバー負荷を減らす為に、リクエスト数を少なくする事もできます。標準では1秒間に5件のリクエストが最適な数値として設定されています。
- リダイレクトの最大数。ウェブサイト検査中にクローラーがスキャンできるリダイレクトの最大数を指定できます。
レポート設定
サイトの項目を分析する際に、SE Rankingは現在の検索エンジンの推奨を参考にしています。 レポート設定 セクションでは、サイトクロール時やレポート収集時にツールで取り扱う項目を変更する事もできます。
さらに、SE Rankingプラットフォームで作成された検査レポートにゲストリンクを作成できる新機能を導入しました。 これらの共有可能なレポートのおかげで、共に作業するスペシャリストへの情報提示が非常に簡単になりました。この機能は、スタンドアロン・ツールとプロジェクト・ベースの検査の両方で利用可能です。
監視項目
検査で考慮しない項目を指定できます。チェックされていない項目はレポートに反映されず、サイトの全体的な健全性スコアには影響しません。